

LLM文章を理解し、考え、生成するAI
大量のデータから言語を理解し、質問に答えたり、文章を生成したりできます。
NVIDIA DGX Sparkプラットフォームベース
世界中で話題!
品切れ続出の超小型AIスーパーコンピューター
| 64GBモデル | 128GBモデル | |
|---|---|---|
| メモリ | 64GB | 128GB |
| SSD | 2TB | 4TB |
| AI演算性能 | 1,000TOPS | 1,000TOPS |
| 1台の価格 | 998,000円(税込) | 1,430,000円(税込) |
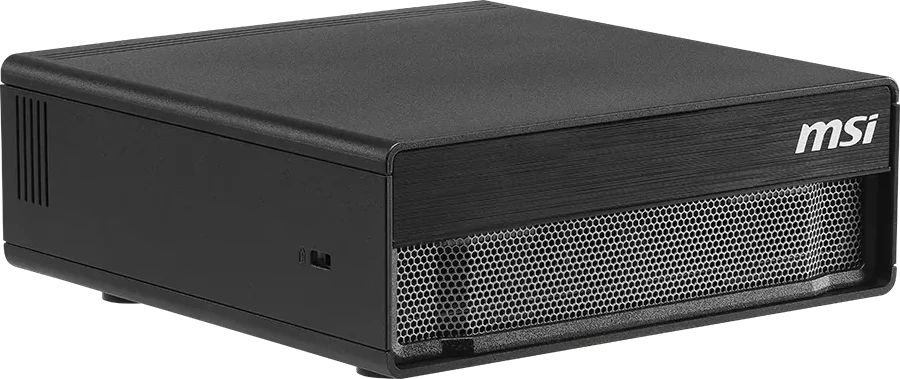
※AI演算性能はFP4(スパース)の理論値。出典:MSI EdgeXpert 製品ページ
※EdgeXpertは、NVIDIA DGX Sparkプラットフォームをベースとした製品です(128GBモデルはDGX Sparkと同じメモリ容量)
※ご注文後のお取り寄せとなる場合がございます。
AI Basics
LLM・RAG・AIエージェント・画像・映像AIとは?
大量のデータから言語を理解し、質問に答えたり、文章を生成したりできます。

社内の文書やデータを検索し、必要な情報を取得してAIの回答に活用します。

複数のAIやツールを組み合わせ、情報収集から作業までを自動で実行します。

画像や映像を解析し、業務の自動化や高度化を実現します。
AI at Work
5つの職種で、具体的な業務の変化を紹介します。
提案までの時間を短縮し、顧客対応の質を向上。
問い合わせ対応の迅速化とベテランの知見を共有。
社内問い合わせ対応を効率化し、業務の負担を軽減。
不良品の早期発見で、品質向上とコスト削減。
研究のスピードアップと新たな発見をサポート。
Workflow
EdgeXpertを使うことで、社内の情報を活用したAIアシスタントやマルチエージェントによる自動化が可能になります。
担当者へ
1 Unit vs 2 Units
1台と2台では、扱えるモデルの規模や複数のAIの組み合わせ、チームでの活用などできることが大きく変わります。
EdgeXpert1台使用
まずAIを社内で動かしてみたい
こんな企業におすすめAIを試したい/まず1つの業務から始めたい
EdgeXpert2台使用
AIを組み合わせて、より本格的に使いたい
こんな企業におすすめ本格的なAI開発/複数部門での活用/将来の拡張を見据えたい
出力1トークンあたりの生成時間(TPOT)
1台269ms»2台133ms
AI演算性能はFP4(スパース)の理論値。B=10億パラメータ。扱えるモデルの規模(最大200B/405B)は、MSI・NVIDIAが公表している128GBモデル(DGX Sparkと同じメモリ容量)の値です。64GBモデルの値は公表されていません。出典:MSI EdgeXpert 製品ページ。TPOTはEdgeXpertのベースである DGX Spark の公表値:NVIDIA Technical Blog(英語)の公表値(日本語は仮訳)。Llama 3.3 70B Instruct(NVFP4)/TensorRT LLM/入力32K・出力1Kトークン/バッチサイズ1での計測。最初のトークンまでの時間は約1.56倍の短縮です。ノード間の通信が多い処理では、効果は直線的になりません。実際の性能は、モデル・設定・処理内容によって異なります。
2台構成だからこそ可能になる、より高度なAI活用のシナリオをご紹介します。
CASE 01
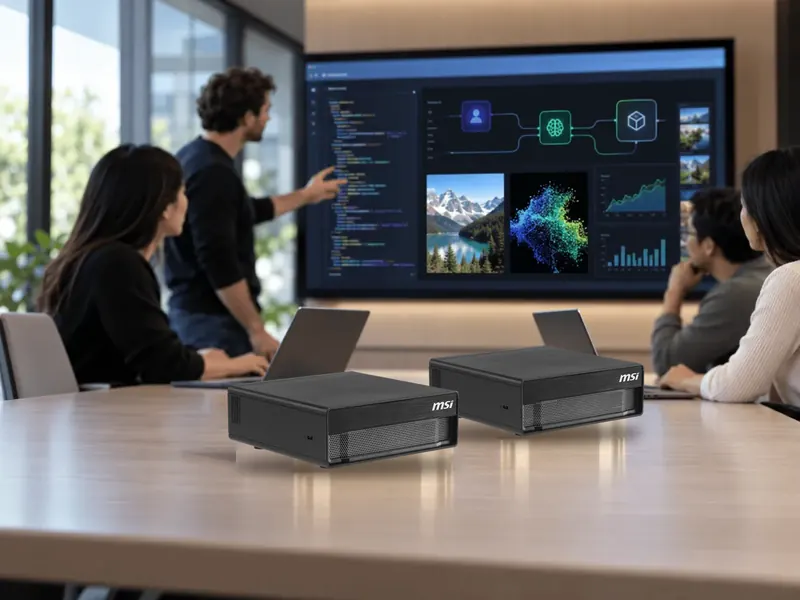
1台ではシンプルなAIアシスタント、2台では複数のAIやエージェントを組み合わせた高度な業務支援が可能です。
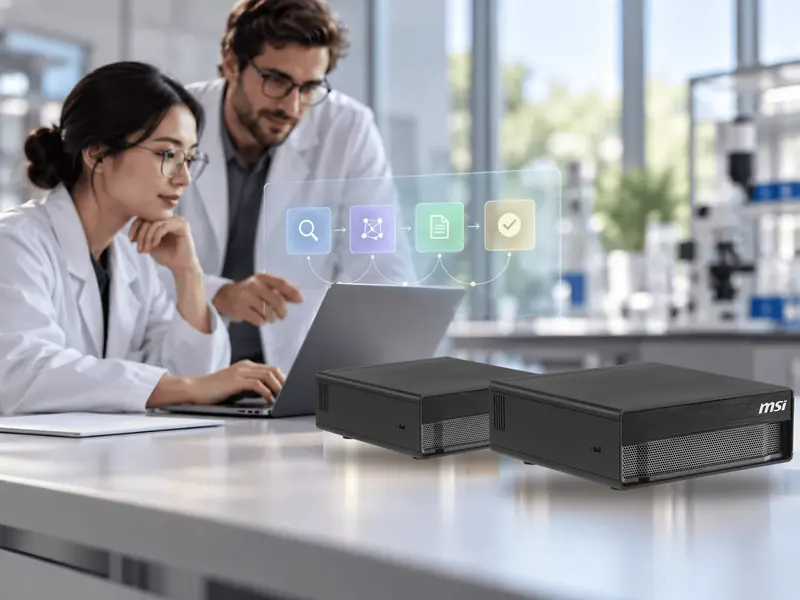
CASE 02
複数のAIエージェントを連携させ、業務の自動化・効率化を実現します。
マルチエージェント型システムの構築が可能です。

CASE 03
2台をクラスタとして構成することで、1台では難しい大規模モデルの利用が可能です。
最大 405B パラメーターのモデル対応(128GBモデル 2台の場合)
※実際に利用可能なモデルサイズや性能は、モデルの量子化方式、推論フレームワーク、コンテキスト長、ワークロードなどによって異なります。
CASE 04
2台構成で、より大規模なAIワークロードを扱いながら、開発・検証用途を組み合わせるなど運用設計の選択肢が広がります。
Built for Developers
「AIを動かす」から「AIシステムを作る」へ。
より大きなモデル、複数のAI、AIエージェント、RAG。
これらを組み合わせ、自社業務に合わせたAIシステムをEdgeXpertで開発する。
About
EdgeXpertは、AIの開発・実行を目的としてゼロから設計されたAIコンピューティングプラットフォームです。NVIDIA GB10 Grace Blackwell Superchipを搭載し、AIエージェント、マルチモーダル推論、ファインチューニング、データサイエンス、エッジAI開発に対応します。
EdgeXpert1台あたりの性能
Why 2 Units
EdgeXpertの統合システムメモリは、
1台あたり64GB(メモリ64GB、SSD2TB仕様)
または128GB(メモリ128GB、SSD4TB仕様)。
2台を連携することで、より大規模なAIモデルの開発・推論に対応します。
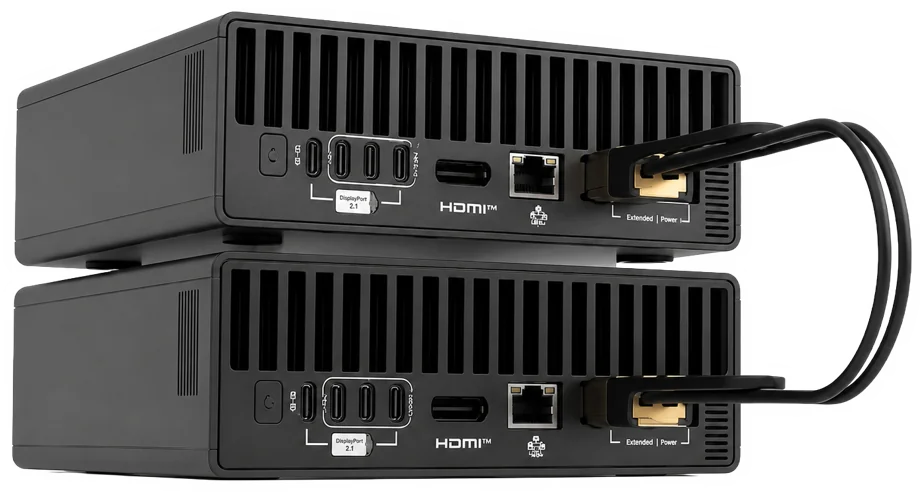
出典:MSI EdgeXpert 製品ページ(拡張可能なデスクトップソリューション)。AI演算性能はFP4(スパース)の理論値。B=10億パラメータ。ConnectX-7ネットワークを内蔵したEdgeXpertは、最大4台のシステムをクラスター化できます。
Performance
TOPS(テラオーピーエス)
=Tera Operations Per Second
※当社比
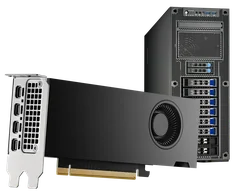
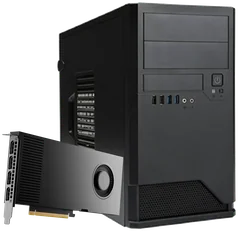
※EdgeXpertはFP4、RTX 4000 SFF Ada/RTX 2000 AdaはFP8の値(いずれもスパース演算時の理論値)。演算精度の条件が異なります。
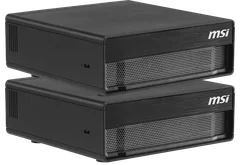
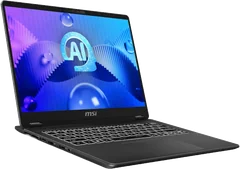
この比較表を見て分かるように、コンシューマークラスのハードウェアで比べてもEdgeXpertは圧倒的なAI性能を保有しています。
このAI性能を表すTOPSという単位を知る上で一つの指標になるのは、Microsoftが発表したCopilot+ PCの性能要件である「40TOPS」という数値です。
これは1秒間に何兆回の演算ができるかを示す指標であり、40TOPSは1秒あたり40兆回の演算が可能で、EdgeXpertは1秒あたり1000兆回のAI演算が可能であることを示しています。
※AI性能を測る指標として「TFLOPS」という浮動小数点演算回数を示す単位がありますが、近年では学習には浮動小数点演算を使うものの、推論には整数演算を使うようになったため、整数演算の性能を示す「TOPS」も重要とされています。
Technology
一般的なパソコンがCPUとグラフィックボードで別々の部品を搭載しているのに対して、EdgeXpertは一つの部品で2つの役割を兼ねています。GPUは最新のNVIDIA Blackwellを、CPUにはintel、AMDに次ぐARM社製の20コアCPUを採用しています。それら2つをNVIDIAの最新技術で繋ぐことによって、CPUとGPUがメモリを共有することができるようになりました。

Unified Memory
メインメモリ(RAM)とGPUメモリ(VRAM)が統合された革新的なメモリ
RAMとVRAMが統合されたユニファイドメモリだからこそできる、圧倒的なグラフィックメモリ容量!
CPUとGPUが1つのメモリ(64GBまたは128GB)を共有するため、GPUで大きなAIモデルを扱えます。
コンパクト筐体のEdgeXpertでも、ハイエンドワークステーション並みのAIモデルサイズに対応!
ここでのポイントは、メモリ容量をメインメモリではなくグラフィックメモリで見ることです。例えばワークステーションに採用される「RTX PRO 6000」はGPUメモリが96GBです。EdgeXpert(メモリ128GB/SSD4TBモデル)は、それを上回る128GBのメモリをCPUとGPUで共有できます。例えばRTX5080はGPUメモリが16GBしか搭載していないため、AI推論には向いていないことが分かります。
最終的に比較する必要があるのは、製品の価格差です。これまで大規模なAIモデルを処理するためには、必ず高価なハイエンドマシンが必要になっていましたが、EdgeXpertは非常にお求めやすい価格で導入することができます。これが、EdgeXpertが「家庭用スパコン」と言われる一番の理由です。
Use Cases
01
AI開発者は、AIモデルのファインチューニングや推論アプリケーションをローカル環境で実行できます。
02
教室や研究室でAIモデルをローカルにトレーニングし、学校のサーバーインフラへ拡張できます。
03
医療従事者や研究者は、診断、ゲノム解析、創薬などの用途でAIモデルをローカル環境で実行できます。
04
NVIDIA Jetson向けのエッジAIビジョントランスフォーマーをファインチューニングし、工場のロボットをリアルタイムで監視・検知するシステムの構築を支援します。
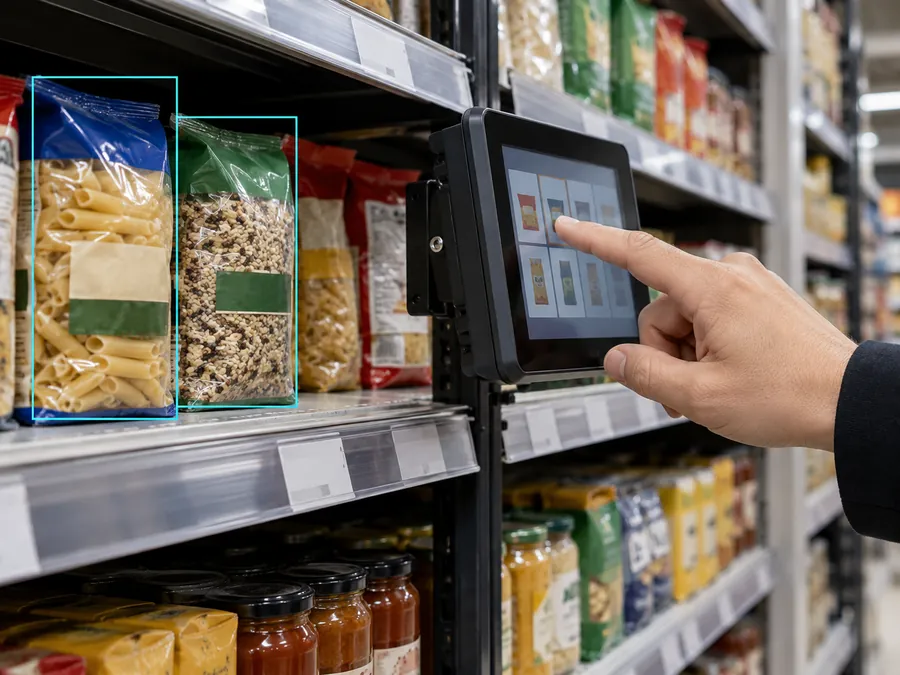
05
ローカルでのデータ処理により、リアルタイムの映像解析やセルフレジの自動化を実現します。
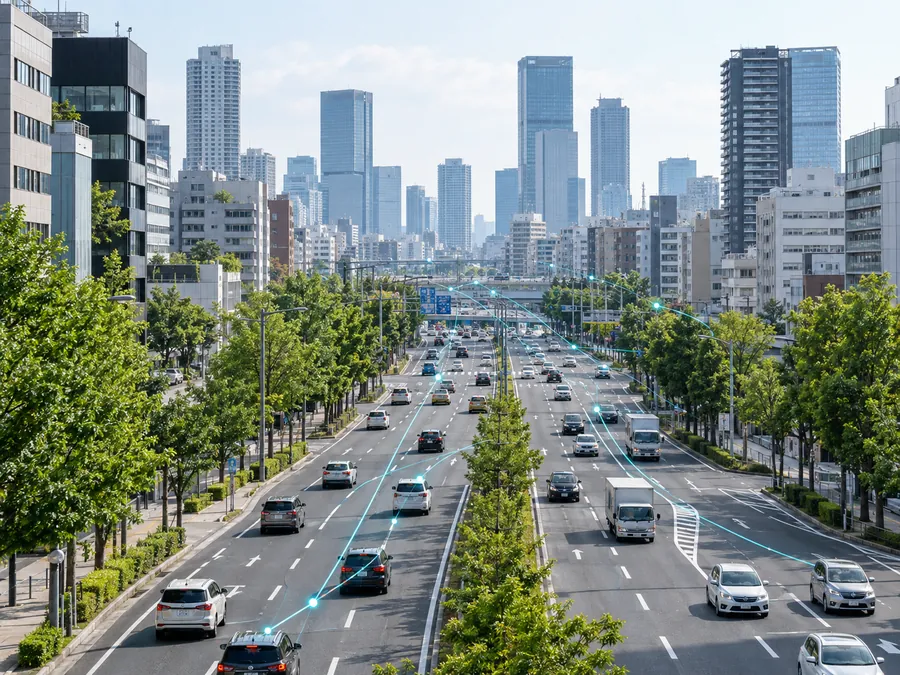
06
NVIDIA MetropolisおよびIsaacフレームワークを活用し、スマートシティ向けのエッジAIを実現。
Features
01
AIモデル、プロンプト、機密性の高い企業データ、24時間365日の推論処理をデバイス内で完結。
02
Ubuntu LinuxをベースにしたDGX OSを搭載し、NVIDIAのAIソフトウェアスタックをあらかじめ構成済み。
03
特許取得済みのFanDock設計で、トークン処理速度を最大10%向上させ、高負荷時の温度を最大15°C低減します。
Price
1台
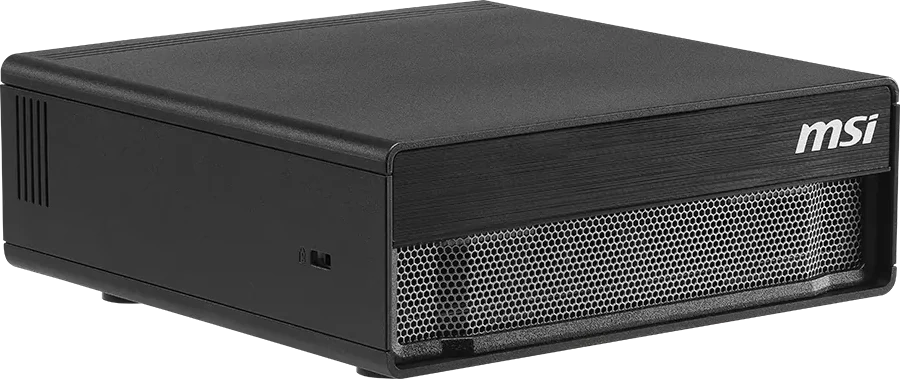
2台セット
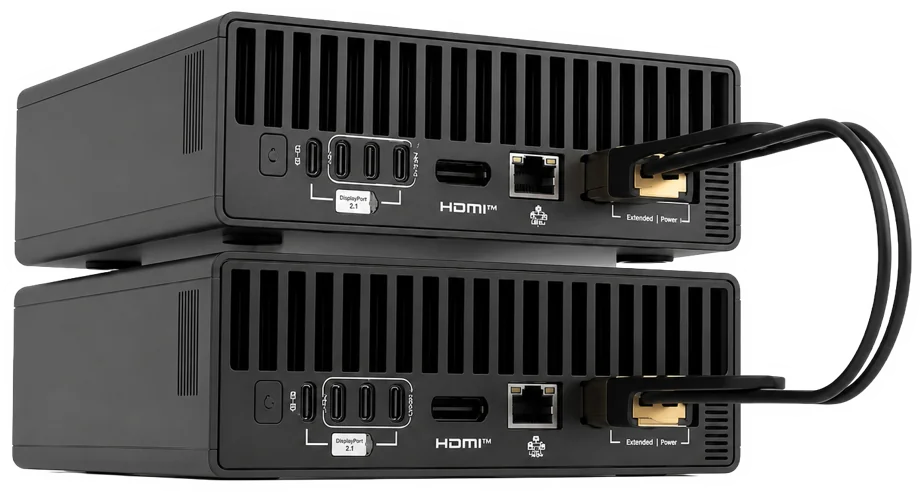
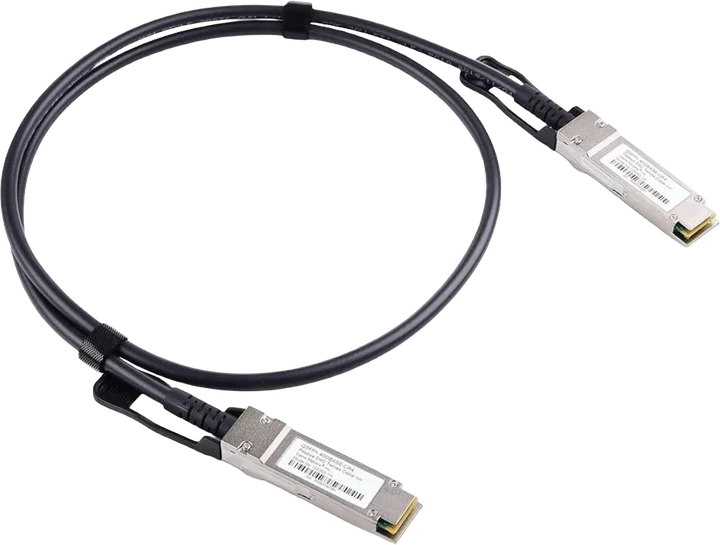
NVIDIA ConnectX-7により、EdgeXpert 2台を高速接続!
セット価格1,946,000円(税込)
1台ずつとケーブルを別々に購入した場合(2,009,200円)より63,200円お得
1台
2台セット
NVIDIA ConnectX-7により、EdgeXpert 2台を高速接続!
セット価格2,798,000円(税込)
1台ずつとケーブルを別々に購入した場合(2,873,200円)より75,200円お得
延長保証の価格は、仕様(メモリ容量)によって異なります。
標準保証1年+延長保証+1年=合計2年
標準保証1年+延長保証+2年=合計3年
13,200円(税込)
※本製品は在庫限り・台数限定でのご提供となります。
※ご注文後のお取り寄せとなる場合がございます。
※在庫状況は仕様ごとに変動します。通販営業担当へお問い合わせください。